Neural Networks - từ một neuron đến mạng nhiều tầng
Bài này trả lời một câu hỏi hẹp: vì sao cộng các đầu vào theo trọng số, rồi uốn tổng đó bằng một hàm phi tuyến, lại gắn được nhãn cho những điểm mà một đường thẳng không tách nổi. Đơn vị làm việc đó gọi là neuron nhân tạo. Nhiều đơn vị ghép lại thành mạng neural, hiểu ở đây là một hàm toán học có nhiều tham số, và các tham số đó được chỉnh từ các ví dụ đã cho nhãn.
Bạn chưa cần thuật toán tìm trọng số, chưa cần ảnh, và chưa cần chuỗi ký tự. Bốn điểm giả định ở giữa bài cho thấy một neuron làm được phép AND. Bốn điểm XOR ngay sau đó cho thấy một tầng tuyến tính bỏ sót một điểm. Bài không hướng dẫn cài đặt, không trình bày vòng lặp huấn luyện, và không xây mạng nhìn ảnh hay mạng đọc chuỗi.
Mỗi đầu vào là một con số. Trọng số là con số cho biết đầu vào đó được phóng đại hay đảo chiều. Bias là số cộng thêm trước khi hàm kích hoạt uốn kết quả. Mạch tối thiểu là: đầu vào, nhân trọng số, cộng bias, rồi hàm kích hoạt.
Đường đọc nhanh: mục 1, mục 2, mục 3, mục 4, mục Khi cách này thất bại, mục 5, mục 6, rồi phần Mang đi. Các mục Đào sâu nằm ngoài đường đó.
1. Từ hình neuron sinh học đến một hàm
Tên “mạng neural” gợi một tế bào nhận nhiều tín hiệu, cộng chúng lại, và có thể phát tín hiệu tiếp. Hình dưới đây, lấy từ bài giảng CS50, chỉ dùng để tạo liên tưởng đó. Đơn vị trong bài này là một công thức, với đầu vào là số và đầu ra là số.
Hình: neuron sinh học trong CS50 AI Lecture 5. Hình chỉ giúp tạo liên tưởng; artificial neuron là mô hình toán học, không phải mô phỏng sinh học đầy đủ.
Hãy đặt một câu hỏi cụ thể, với số giả định, không phải hồ sơ một lớp thật. Ta muốn gắn nhãn “qua” hoặc “trượt” từ hai đầu vào đã nằm trong khoảng từ 0 đến 1: tỉ lệ buổi có mặt, và điểm bài thực hành đã chia cho thang điểm. Gọi hai đầu vào là và . Gọi nhãn mong muốn là 1 cho “qua” và 0 cho “trượt”.
Một đường thẳng trên mặt phẳng này có dạng “tổ hợp tuyến tính bằng không”. Phía bên này của đường là một nhãn, phía bên kia là nhãn còn lại. Nếu các điểm 1 và các điểm 0 thực sự nằm hai bên một đường như vậy, một neuron với ngưỡng cứng là đủ. Nếu chúng nằm xen kẽ, một đường thì thiếu. Phần tính tay bên dưới làm cả hai việc đó trên các tọa độ cố định, để bạn thấy ranh giới bằng phép cộng chứ bằng một lời mô tả chung.
Neuron nhân tạo nhận đầu vào. Mỗi đầu vào có một trọng số riêng. Kết luận của bước cộng là một số thực , chưa phải nhãn. Số đó bằng tổng các tích trọng số với đầu vào, cộng bias:
Viết gọn, với là cột các trọng số và là cột các đầu vào, cùng một tổng có dạng tích vô hướng cộng bias:
Hàm kích hoạt, ký hiệu , uốn thành đầu ra . Kết luận của bước uốn là: đầu ra không còn buộc phải tỉ lệ thuận với .
Ba chữ cần giữ đúng nghĩa ngay từ đầu. Tham số là số mà quá trình học sẽ đổi, ở bài này là trọng số và bias; bài này chưa tính bước đổi đó. Đầu ra của một neuron có thể là đầu vào của neuron sau, nên một tầng chưa phải cả mạng. Lớp tuyến tính là một tầng chỉ làm phép cộng có trọng số và cộng bias, chưa uốn.
2. Trọng số phóng đại, bias dịch ngưỡng, hàm kích hoạt uốn
Trọng số gắn với đúng đầu vào . Khi dương và lớn, tăng làm tăng . Khi âm, tăng làm giảm . Độ lớn của là mức phóng. Dấu của là chiều. Bias cộng vào sau khi mọi tích đã xong, nên bias dịch cả ngưỡng: cùng một bộ trọng số, đổi bias là đổi chỗ đường ranh giới cắt các trục.
Lấy bộ số sẽ dùng ở mục 3: , , . Đường ranh giới là tập các điểm có , tức , hay . Điểm cho , nằm một phía. Điểm cho , nằm phía kia. Bias là lý do gốc tọa độ chưa đủ để vượt ngưỡng: cả hai đầu vào phải cùng lớn thì tổng mới dương.
Trong một mạng nhiều tầng, một trọng số riêng thường không còn câu chuyện một ý. Tầng sau còn nhân và uốn tiếp. Vì vậy câu “trọng số điểm thực hành gấp đôi trọng số chuyên cần” chỉ an toàn khi cả mô hình là một neuron và bạn đang nói về chính bộ số đó. Ở mạng sâu, cùng một đầu vào đi qua nhiều đường, và mỗi đường còn bị hàm kích hoạt bẻ.
Nếu mọi tầng chỉ là tuyến tính, xếp chúng lại vẫn ra một phép tuyến tính. Kết luận này có thể kiểm bằng hai bước và một giá trị số. Tầng một nhận và tính . Tầng hai tính . Thế vào:
Với , tầng một cho . Tầng hai cho . Phép gộp , cùng một kết quả. Hai tầng đã tốn công, nhưng với đầu vào này chúng trùng một phép nhân và một số trừ . Hàm kích hoạt phi tuyến nằm giữa hai tầng thì phép thế như trên không còn ra một đường thẳng. Đó là lý do mạng cần một lần uốn giữa các lần cộng.
Hàm ngưỡng, còn gọi là step, biến thành một bit. Kết luận của hàm này trên perceptron cổ điển là một nhãn cứng:
Hàm sigmoid ép mọi số thực vào khoảng mở từ 0 đến 1. Kết luận của công thức là một đầu ra trơn, lớn dần khi tăng, và không nhảy từ 0 lên 1 tại một ngưỡng:
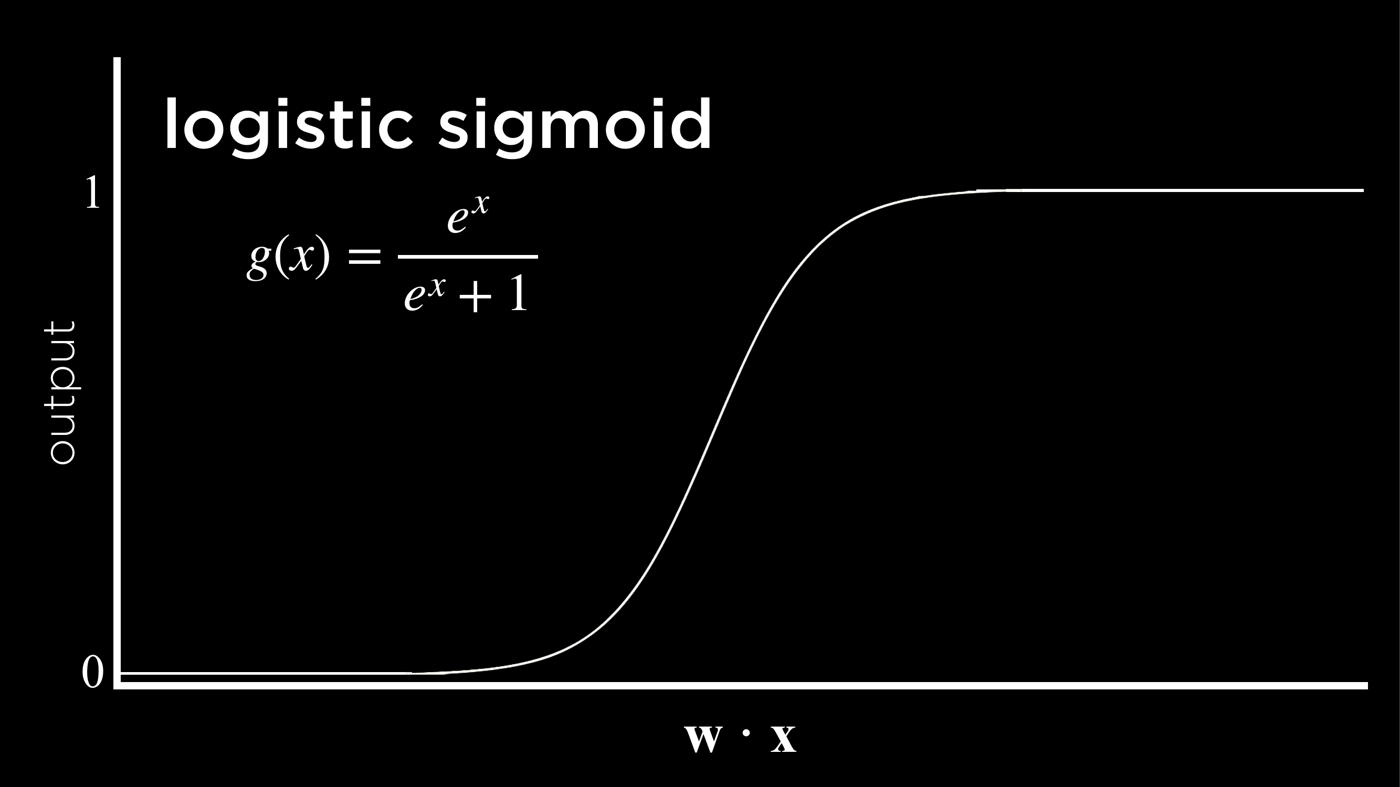
Tại , mẫu số là , nên . Ba giá trị khác được tính từ cùng công thức rồi làm tròn nửa lên tới bốn chữ số thập phân: ra , ra , và ra . Các số làm tròn này cho thấy đầu ra dương lớn hơn và đầu ra âm nhỏ hơn trên ba điểm đã chọn. Chúng chưa phải xác suất của một sự kiện, trừ khi mô hình được huấn luyện và hiệu chỉnh để đọc theo cách đó.
ReLU, viết tắt của rectified linear unit, giữ số dương và đổi số âm thành 0. Kết luận của hàm này là một nếp gập tại 0, rẻ về tính toán, và vẫn phi tuyến vì hai phía của 0 không cùng một đường thẳng:
Cùng các mốc vừa dùng: , , , . So với sigmoid trên cùng các mốc, ReLU không nén số dương về dưới 1. Sigmoid thì luôn nằm trong khoảng từ 0 đến 1. Chỗ dùng từng hàm được nói kỹ hơn ở mục đào sâu; phần tính tay phía trước dùng hàm ngưỡng để mọi nhãn ra đúng 0 hoặc 1, không phải số làm tròn.
3. Ví dụ tính tay: perceptron trên bốn điểm
Perceptron ở mục này là một neuron với hàm ngưỡng: đầu ra bằng 1 khi , và bằng 0 khi . Bộ tham số được chọn sẵn để minh họa phép AND, không phải kết quả của một lần huấn luyện. Trọng số , , bias . Bốn điểm và nhãn AND là gắn 0, gắn 0, gắn 0, và gắn 1.
Điểm . Tích thứ nhất là . Tích thứ hai là . Cộng bias: . Vì , đầu ra là 0, trùng nhãn.
Điểm . Tích thứ nhất là . Tích thứ hai là . Cộng bias: . Vì , đầu ra là 0, trùng nhãn.
Điểm . Tích thứ nhất là . Tích thứ hai là . Cộng bias: . Vì , đầu ra là 0, trùng nhãn.
Điểm . Tích thứ nhất là . Tích thứ hai là . Cộng bias: . Vì , đầu ra là 1, trùng nhãn.
Bốn lần tính cho cùng một kết quả: với bộ số này, perceptron gắn đúng cả bốn nhãn AND. Điều phép tính cho thấy là sự khớp trên bốn điểm đã chọn. Nó không cho thấy mọi quan hệ logic hai bit đều tách được bằng một đường, và mục thất bại ngay sau phần tuyến tính sẽ dùng XOR để thấy một quan hệ không khớp.
Hai điểm nằm giữa các ô vuông giúp đọc đường ranh giới. Điểm cho , đầu ra 0. Điểm cho , đầu ra 1. Điểm cho , đầu ra 0. Cả ba điểm đều dùng cùng công thức . Chúng là điểm thử trên luật đã viết, không phải bốn điểm AND ban đầu.
Có thể thấy bias đang làm việc bằng cách đổi mỗi điểm một lượng sau khi cộng hai đầu vào. Tại tổng hai đầu vào là , trừ còn , vừa đủ dương. Tại tổng hai đầu vào là , trừ còn , vẫn âm. Ngưỡng thực sự của tổng vì vậy là : tổng từ trở lên thì nhãn 1. Trên các góc của hình vuông đơn vị, chỉ có đạt mức đó. Đó là lý do cùng một bộ trọng số dương lại ra đúng bảng AND, với hàm ngưỡng này.
4. Vì sao một tầng tuyến tính có hình học rất rõ
Trên mặt phẳng hai đầu vào, phương trình là một đường thẳng, miễn là không phải cả hai trọng số cùng bằng 0. Hàm ngưỡng gán một nhãn cho nửa mặt phẳng và nhãn kia cho nửa . Bài toán gọi là tách được bằng đường thẳng khi tồn tại ít nhất một bộ làm đúng mọi điểm huấn luyện theo luật đó.
OR cũng là một bảng tách được. Một bộ minh họa, vẫn chọn tay, là , , . Điểm cho , đầu ra 0. Điểm cho , đầu ra 1. Điểm cho , đầu ra 1. Điểm cho , đầu ra 1. Bốn nhãn OR đều khớp bộ số này. AND ở mục 3 và OR ở đây khác nhau ở bias, so với , trong khi trọng số giữ nguyên. Đổi bias là đổi ngưỡng của cùng một hướng .
Hình học đó cũng nói giới hạn. Mọi điểm cùng nhãn theo perceptron phải nằm trong một nửa mặt phẳng lồi. Nếu một điểm nhãn 1 nằm trong đoạn thẳng nối hai điểm nhãn 0, không có nửa mặt phẳng nào chứa đúng các điểm 1 mà loại các điểm 0. XOR được dựng đúng theo kiểu xen kẽ đó. Phần sau không chỉ vẽ hình: nó viết các bất đẳng thức và chỉ ra chúng không đứng cùng nhau, rồi tính một bộ số cụ thể để thấy điểm nào bị gắn sai.
Khi cách này thất bại
XOR gắn nhãn như sau: là 0, là 1, là 1, và là 0. Hai điểm nhãn 1 nằm trên một đường chéo. Hai điểm nhãn 0 nằm trên đường chéo kia.
XOR

x2
1 |  1      0
  |
0 |  0      1
  +------------- x1
     0      1
Thử đúng bộ số của phép OR ở trên, , , , trên bảng XOR.
Điểm : , đầu ra 0, trùng nhãn 0. Điểm : , đầu ra 1, trùng nhãn 1. Điểm : , đầu ra 1, trùng nhãn 1. Điểm : , đầu ra 1, trong khi nhãn XOR là 0. Bộ số này khớp ba điểm và sai điểm .
Sai một bộ số chưa nói lên mọi bộ số đều sai. Phần tiếp theo xét một bộ bất kỳ, với cùng luật đầu ra 1 khi và đầu ra 0 khi . Giả sử bộ đó gắn đúng cả bốn nhãn XOR. Khi ấy bốn điều sau phải cùng đúng.
Với nhãn 0, cần . Với nhãn 1, cần . Với nhãn 1, cần . Với nhãn 0, cần .
Cộng hai bất đẳng thức giữa: . Trừ đi một lần ở hai vế, ta được . Vì , số đối là số dương. Vế trái vì vậy lớn hơn hoặc bằng một số dương, nên .
Điều kiện của điểm lại đòi . Một số không thể vừa lớn hơn 0 vừa nhỏ hơn 0. Các bất đẳng thức của bốn nhãn XOR không đứng cùng nhau. Phép tính này cho thấy không có bộ nào, với hàm ngưỡng nêu trên, gắn đúng cả bốn điểm. Nó không nói gì về một mạng đã có tầng ẩn, và mục 5 sẽ chọn tay một mạng như vậy trên cùng bốn điểm.
Thất bại này là thất bại của một lần cộng rồi một lần ngưỡng. Thêm đầu vào thứ ba vẫn là một siêu phẳng, tức một lát cắt phẳng trong không gian cao hơn, nếu tầng đó vẫn tuyến tính cộng ngưỡng. Độ dày của mô hình chỉ tăng thật khi có một bước phi tuyến ở giữa, hoặc khi chính hàm cần học đã là một nửa mặt phẳng. Trên dữ liệu thật, người ta không nhìn bốn góc rồi kết luận cả bài toán. Dấu hiệu cùng kiểu là: biểu đồ hai đặc trưng cho thấy các lớp nằm xen, hoặc một mô hình tuyến tính đã được thử và sai có cấu trúc, không phải sai ngẫu nhiên từng điểm.
Một cách đọc nhầm dễ gặp là đổ lỗi cho hàm sigmoid. Sigmoid một tầng vẫn là một ngưỡng mềm trên cùng một tổng . Đường mức trùng đường . Uốn trơn làm đầu ra thành xác suất mềm, nếu ta đọc nó như vậy, nhưng ranh giới một ngưỡng vẫn là đường thẳng của . XOR không được cứu bằng cách đổi step sang sigmoid trên cùng một tầng.
5. Hai đơn vị ẩn gắn lại bốn điểm XOR
Mục này chọn tay các trọng số để bốn điểm XOR ra đúng nhãn. Đây là một ví dụ tồn tại, tức là một mạng nhỏ làm được bảng này, không phải một lần học từ dữ liệu. Mỗi đơn vị ẩn dùng hàm ngưỡng.
Đơn vị ẩn thứ nhất tính , rồi khi , ngược lại . Với các góc của hình vuông, đơn vị này bật khi có ít nhất một đầu vào bằng 1.
Đơn vị ẩn thứ hai tính , rồi khi , ngược lại . Đơn vị này chỉ bật khi cả hai đầu vào bằng 1.
Đầu ra tính , rồi nhãn 1 khi . Trọng số của là , trọng số của là , bias là . Nói bằng lời: đầu ra bật khi đơn vị thứ nhất bật và đơn vị thứ hai tắt.
Điểm . Đơn vị một: , nên . Đơn vị hai: , nên . Đầu ra: , nhãn 0, trùng XOR.
Điểm . Đơn vị một: , nên . Đơn vị hai: , nên . Đầu ra: , nhãn 1, trùng XOR.
Điểm . Đơn vị một: , nên . Đơn vị hai: , nên . Đầu ra: , nhãn 1, trùng XOR.
Điểm . Đơn vị một: , nên . Đơn vị hai: , nên . Đầu ra: , nhãn 0, trùng XOR.
Trên cả bốn điểm, nhãn tính được trùng nhãn XOR. Phép tính cho thấy hai đơn vị ẩn với hàm ngưỡng, rồi một đơn vị ra, đủ để gắn đúng bảng này với các trọng số đã chọn. Nó không cho thấy mạng sẽ tự tìm ra các trọng số đó, và không cho thấy mọi hàm hai bit đều cần đúng hai đơn vị ẩn.
Đáng chú ý là từng đơn vị ẩn một mình vẫn là một perceptron. Đơn vị một khớp OR. Đơn vị hai khớp AND, đúng bộ số của mục 3. Tầng ra làm một phép trừ: lấy “có ít nhất một bit bật” rồi loại trường hợp “cả hai cùng bật”. XOR trong cách dựng này là OR trừ AND. Tầng ẩn đã biến bốn góc thành các cặp dễ tách hơn: , , , và . Hai điểm nhãn 1 của XOR rơi vào cùng một cặp . Điểm nhãn 0 còn lại rơi vào hoặc . Trên mặt phẳng các , một đường đã tách được. Phần việc phi tuyến nằm ở chỗ các là hàm ngưỡng của , nên đường thẳng ở tầng sau tương ứng một ranh giới gập trên mặt phẳng đầu vào.
6. Mạng nhiều tầng và biểu diễn trung gian
Một mạng nhiều tầng, thường gọi là multilayer perceptron khi mọi tầng là nối đầy đủ, xếp ba vai. Tầng vào giữ các số đo ban đầu, và thường không tự có trọng số. Một hoặc nhiều tầng ẩn tính các vector trung gian. Tầng ra phát nhãn hoặc một số dự đoán. Hình dưới đây là sơ đồ các tầng đó.
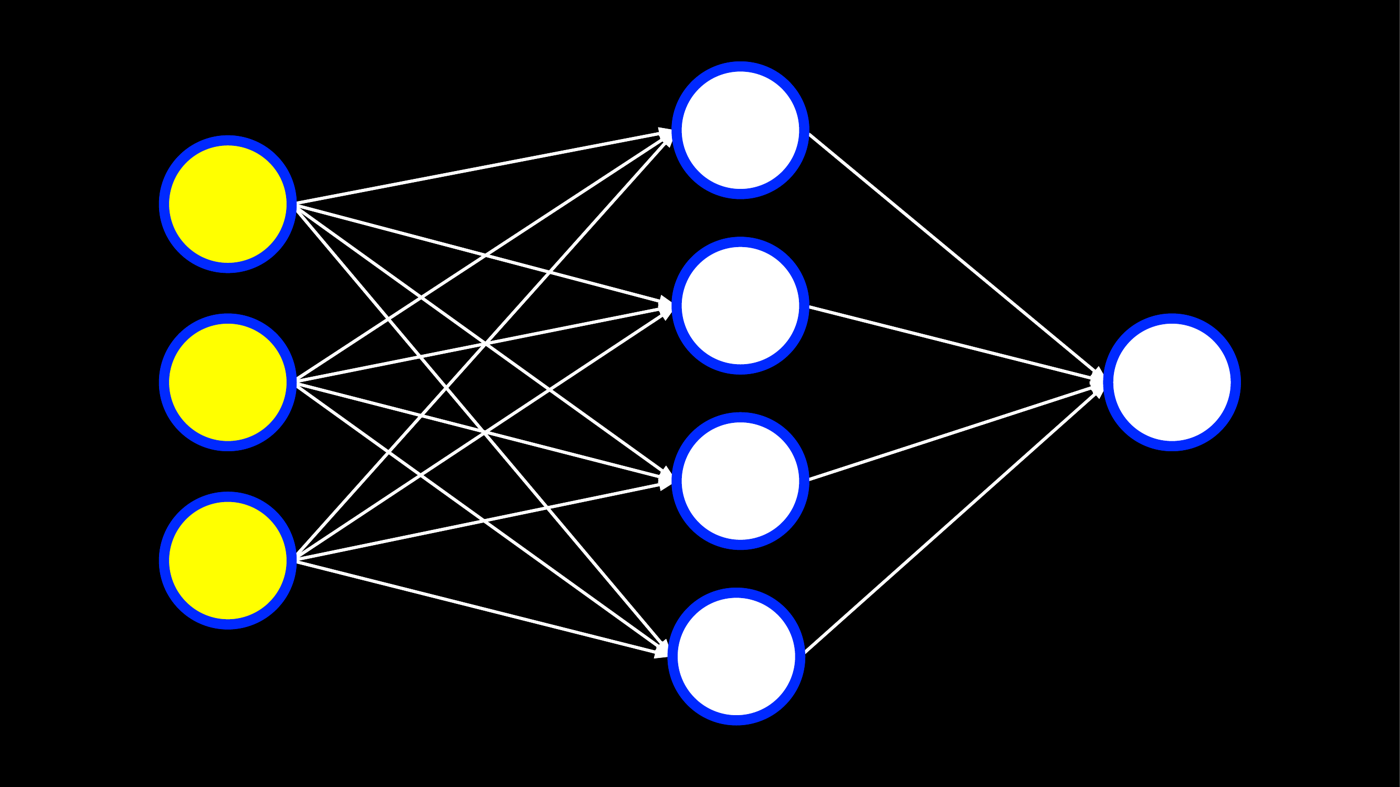
Mỗi mũi tên trong hình là một trọng số. Mỗi nút ẩn làm đúng mạch của mục 1: tổng có trọng số, cộng bias, rồi hàm kích hoạt. Khác biệt với perceptron một tầng là đầu vào của nút sau có thể là đầu ra đã uốn của nút trước, như và trong mục 5.
Người ta hay nói tầng ẩn “học đặc trưng”. Trong ví dụ XOR, đặc trưng không bí ẩn: là một bit OR và là một bit AND, với các trọng số ta đã viết. Trên ảnh hay trên một bảng đo lớn, đơn vị ẩn thường không trùng một tên gọi sẵn. Điều vẫn đúng là tầng ẩn tính một biểu diễn khác của cùng đầu vào, và tầng sau phân loại trên biểu diễn đó. Mạng vì vậy vừa tìm cách biểu diễn, vừa tìm cách gắn nhãn, trong cùng một họ tham số. Bài huấn luyện sẽ nói cách chỉnh các tham số. Bài này chỉ cần thấy biểu diễn trung gian có thể làm một bảng không tách tuyến tính trở thành tách được ở tầng sau.
Một chuỗi biến đổi viết được như sau. Kết luận của sơ đồ là dữ liệu gốc, các vector ẩn, và dự đoán là ba vật khác nhau:
Ký hiệu là dự đoán, để phân biệt với nhãn đã cho. Với ảnh một lá cây, chuỗi có thể là các mức sáng đỏ-xanh-lục, rồi các đáp ứng cục bộ, rồi một vector mà tầng cuối đọc thành điểm cho từng bệnh. Ta không cần giả định rằng một nút ẩn “là” mép lá. Nhiều nút cùng tham gia một dấu hiệu là chuyện bình thường. Điều cần giữ là thông tin không gian của ảnh sẽ bị bàn ở bài tích chập; mạng nối đầy đủ trong bài này coi mỗi đầu vào là một tọa độ của vector, chưa có ưu tiên cho các pixel kề nhau.
Chọn hàm ở tầng ra theo kiểu câu trả lời. Hồi quy một số thực, chẳng hạn một điểm số, thường để tầng ra tuyến tính, tức là phát chính . Phân loại hai lớp với một xác suất cho lớp dương thường dùng sigmoid. Phân loại nhiều lớp mà đúng một lớp thì softmax biến một vector điểm thành các số dương cộng lại bằng 1. Khi hai điểm bằng nhau, softmax chia đều: với hai điểm ,
Mỗi lớp nhận . Phép này không cần xấp xỉ hàm mũ, vì hai số mũ bằng nhau và rút gọn. Nếu nhiều nhãn có thể đúng cùng lúc trên một mẫu, mỗi nhãn một sigmoid là cách đọc tự nhiên hơn một softmax, vì softmax buộc các đầu ra tranh nhau một tổng bằng 1.
Mạng sâu, hay deep learning trong cách dùng hẹp, là mạng neural có nhiều tầng ẩn. Thêm tầng tăng khả năng biểu diễn khi giữa các tầng có phi tuyến, như phép gộp tuyến tính ở mục 2 đã cho thấy điều ngược lại. Thêm tầng cũng tăng số tham số và số chỗ có thể chỉnh sai. Bài sau mới nói loss và bước cập nhật. Ở đây, “sâu” chưa có nghĩa là chính xác hơn.
Đào sâu: đọc sigmoid, ReLU, và chỗ đặt chúng
Hàm ngưỡng gần như phẳng trên từng nửa đường thẳng. Đạo hàm của nó bằng 0 ở mọi nơi trừ đúng ngưỡng, nơi đạo hàm không tồn tại theo nghĩa thông thường. Khi bài sau truyền một tín hiệu “hãy sửa trọng số” từ loss về phía trước, một hàm phẳng không cho độ dốc để sửa. Sigmoid và ReLU được dùng rộng vì chúng có đoạn độ dốc khác 0. Sigmoid có độ dốc nhỏ khi rất dương hoặc rất âm: các giá trị đã tính, tại và tại , đã nằm gần hai đầu khoảng . ReLU có độ dốc 1 khi và độ dốc 0 khi . Đơn vị ReLU nào nhận âm thì tắt trên mẫu đó; mục tính tay của bài huấn luyện sẽ gặp một trường hợp tắt như vậy sau một bước cập nhật.
Một bảng đặt hàm cho lần đọc đầu:
| Chỗ đặt | Hàm hay gặp | Đầu ra đang là gì |
|---|---|---|
| Tầng ẩn | ReLU hoặc một biến thể gần ReLU | một đặc trưng đã bị gập |
| Hai lớp, một xác suất | Sigmoid | một số trong khoảng 0 đến 1 |
| Nhiều lớp, đúng một lớp | Softmax | các số dương, tổng bằng 1 |
| Nhiều nhãn độc lập | Một sigmoid mỗi nhãn | mỗi nhãn một số trong khoảng 0 đến 1 |
| Dự đoán một số thực | Tuyến tính ở tầng ra | chính tổng có trọng số |
Bảng là thói quen thiết kế, không phải một định lý rằng mọi bài toán phải theo đúng ô. Một tầng ra tuyến tính trên bài phân loại sẽ phát số âm và số lớn hơn 1, và người đọc phải tự quyết định ngưỡng. Một softmax trên bài hồi quy giá sẽ ép dự đoán thành một phân phối, sai kiểu câu trả lời.
Còn một giới hạn của chính ReLU: nếu mọi đầu vào của một đơn vị đều đẩy về phía âm trong suốt quá trình học, đơn vị đó phát 0 và độ dốc cục bộ bằng 0, nên các trọng số đi vào nó không nhận tín hiệu sửa từ các mẫu đó. Người ta gọi tình huống này là đơn vị chết. Nó là một lý do thực hành để khởi tạo và tốc độ học không được đẩy âm hàng loạt. Bài này chỉ cần nhận ra triệu chứng trên công thức: triệt tiêu cả đầu ra lẫn độ dốc khi .
Đào sâu: vài mốc, để thấy đây không phải một ý tưởng của riêng thập niên này
Các mốc dưới đây là lược sử đã gắn với các tài liệu ở cuối bài, để đặt perceptron và mạng nhiều tầng vào một dòng dài. Chúng không phải một chứng minh rằng một kiến trúc sẽ thắng trên dữ liệu của bạn.
| Mốc | Điều người học thường cần nhớ |
|---|---|
| Thập niên 1940 | đã có mô hình toán sơ khai của neuron |
| 1958 | Rosenblatt mô tả perceptron như một mô hình học |
| Thập niên 1960–1970 | giới hạn của perceptron một tầng được thấy rõ hơn; đây chỉ là một phần của giai đoạn AI ít được kỳ vọng |
| 1986 | Rumelhart, Hinton và Williams trình bày cách huấn luyện mạng nhiều tầng bằng backpropagation theo cách có ảnh hưởng lớn |
| Thập niên 1990 | mạng tích chập và mạng hồi tiếp trở nên thực dụng hơn trên chữ viết, chuỗi và tín hiệu |
| 2012 | AlexNet cho thấy mạng tích chập sâu, cùng GPU và dữ liệu lớn, tạo một bước nhảy trên ImageNet |
| 2017 | kiến trúc Transformer cho thấy mô hình chuỗi có thể dựa vào attention thay vì vòng lặp thời gian |
Điều đáng giữ từ bảng là sự hội tụ: kiến trúc, cách tối ưu, lượng dữ liệu, phần cứng, và phần mềm tính gradient đã đến cùng một giai đoạn. Một công thức perceptron từ 1958 vẫn là công thức mục 3 của bài này. Phần đổi là ta ghép được nhiều tầng, tính được độ dốc, và có đủ dữ liệu để các tầng đó có gì để học. Bài Language và khóa kiến trúc học sâu sẽ đi tiếp từ attention; bài này dừng ở chỗ một tầng ẩn đã đổi được biểu diễn của XOR.
Tự kiểm tra
- Với , vì sao rồi ra cùng kết quả với ? Hãy tính cả hai đường.
- Trên bộ AND , , , điểm cho bằng bao nhiêu, và nhãn ngưỡng là gì?
- Bộ , , sai điểm XOR nào, và tại đó bằng bao nhiêu?
- Trong mạng hai tầng ẩn của mục 5, cặp tại là gì, và vì sao đầu ra lại âm?
- Bài dự đoán một giá tiền nên để tầng ra là sigmoid, softmax, hay tuyến tính? Bài chọn đúng một trong sáu nhãn thì sao?
Mang đi
Một neuron tính tổng có trọng số, cộng bias, rồi đưa qua hàm kích hoạt. Trọng số và bias là tham số. Trên bốn điểm AND, bộ , , với hàm ngưỡng cho bốn nhãn đúng: ba điểm đầu ra 0 và điểm có nên ra 1. Trên XOR, bộ , , sai điểm với , và các bất đẳng thức cho thấy không có bộ trọng số nào của một hàm ngưỡng gắn đúng cả bốn điểm. Hai đơn vị ẩn, một cái theo OR và một cái theo AND, rồi một tầng ra lấy hiệu, gắn đúng bốn điểm XOR với các trọng số đã viết. Hai tầng chỉ toàn phép tuyến tính thì gộp lại vẫn là một phép tuyến tính, như đi qua thành . Mạng nhiều tầng có ích khi giữa các tầng có một lần uốn, vì lúc đó tầng sau được nhìn một biểu diễn khác của đầu vào.
Bài sau lấy các trọng số này làm đối tượng cần tìm: một loss bậc hai, một tốc độ học, và một bước cập nhật được tính ra số.
Nguồn tham khảo
- CS50 AI, Lecture 5 - Neural Networks: https://cs50.harvard.edu/ai/notes/5/
- Rosenblatt, F. (1958), The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain, Psychological Review, DOI: 10.1037/h0042519.
- Rumelhart, D. E., Hinton, G. E., Williams, R. J. (1986), Learning representations by back-propagating errors, Nature, DOI: 10.1038/323533a0.
- Krizhevsky, A., Sutskever, I., Hinton, G. E. (2012), ImageNet Classification with Deep Convolutional Neural Networks, NeurIPS.
- Vaswani, A. et al. (2017), Attention Is All You Need, arXiv:1706.03762.