Recurrent Neural Networks - RNN và dữ liệu tuần tự
Bài này trả lời vì sao cùng một bộ trọng số phải chạy lại trên từng bước của một chuỗi, thay vì xem cả chuỗi như một vector không có thứ tự. Mạng làm vậy gọi là mạng neural hồi tiếp, viết tắt RNN, từ recurrent neural network. Trạng thái ẩn là một số, hoặc một vector số, mang phần tóm tắt của các bước trước sang bước hiện tại.
Bạn có thể đọc khi chỉ nhớ rằng huấn luyện sửa trọng số theo đạo hàm của một loss. Bài tính hai bước với trạng thái ban đầu, hai đầu vào, và các trọng số cho sẵn, toàn số giả định. Bài nói vì sao một chuỗi dài làm tín hiệu sửa trọng số teo dần, ở mức một tích các hệ số. Vài đoạn sau chỉ nói cổng nào của LSTM và GRU quyết định giữ hay quên, rồi trỏ sang khóa kiến trúc học sâu. Bài không khai triển đạo hàm qua thời gian, không viết đủ công thức các cổng, và không xây Transformer.
Các giá trị và bên dưới là kết quả của các phép cộng đã viết. Chúng không phải độ chính xác của một bộ gõ tiếng Việt hay của một mô hình điểm danh thật.
Đường đọc nhanh: mục 1, mục 2, mục 3, mục Khi cách này thất bại, mục 4, rồi phần Mang đi. Các mục Đào sâu nằm ngoài đường đó.
1. Chuỗi có thứ tự, và tầng không vòng thì không giữ bước trước
Hai câu dưới đây dùng gần cùng các từ. Đổi thứ tự là đổi điều người nói đang hỏi.
Sinh viên không đỗ môn AI.
Sinh viên đỗ môn AI, không?
Một túi từ, tức một bản đếm số lần mỗi từ xuất hiện, có thể gần giống nhau cho hai câu nếu chỉ nhìn tập từ. Thứ tự “không” đứng trước hay sau cụm “đỗ môn” không còn là một trục của vector. Mạng nối đầy đủ trên vector đó vì vậy không có chỗ để viết “từ này đứng sau từ kia”, trừ khi người thiết kế đã gắn thêm các đặc trưng vị trí bằng tay.
Với một dãy đo, cùng chuyện đó. Dãy giả định không chỉ là năm số. Khoảng tăng ở cuối lớn hơn khoảng tăng ở đầu. Một mô hình nhận cả năm số cùng lúc vẫn có thể học một trọng số riêng cho từng vị trí, và lúc đó độ dài chuỗi bị khóa theo số cột. RNN làm một việc khác: một bước tính được viết một lần, rồi dùng lại cho bước một, bước hai, bước ba, với cùng trọng số, và với trạng thái đổi.
Mạng đi tới, không có vòng, tính cho từng mẫu độc lập. Đưa lần lượt các từ “hôm”, “nay”, “trời”, “mưa” vào một mạng như vậy, mỗi từ là một mẫu riêng, thì từ “mưa” không nhận được một đường tính từ “hôm”. RNN thêm đường đó bằng trạng thái ẩn.
2. Ví dụ tính tay: từ sang rồi
Ví dụ này cố ý dùng trạng thái là một số, không phải một vector, để từng tích hiện trên trang. Mạng thật thường để là nhiều số. Cách dùng lại trọng số thì cùng kiểu. Công thức một bước: nhân đầu vào hiện tại với , nhân trạng thái trước với , cộng bias, rồi uốn bằng ReLU. ReLU giữ số dương và đổi số âm thành . Kết luận của một bước là trạng thái mới chỉ phụ thuộc đầu vào bước này, trạng thái ngay trước, và bộ số dùng chung:
Các số cho sẵn, không phải số học được: , , , , , .
Bước . Tích với đầu vào: . Tích với trạng thái trước: . Cộng bias: . Vậy . Vì , ReLU cho .
Bước . Tích với đầu vào: . Tích với trạng thái trước, lúc này là : . Cộng bias: . Vậy . Vì , ReLU cho .
Hai kết quả: và . Cùng bộ đã chạy hai lần. Lần thứ hai không có trọng số mới; nó nhận thay cho , và nhận thay cho . Phép tính cho thấy trạng thái đã đổi từ thành ở bước một, rồi từ thành ở bước hai, dưới các số này. Nó không cho thấy một RNN sẽ dự đoán đúng từ tiếp theo của một câu thật.
Có thể tách phần còn lại trong , khi cả hai ReLU đang mở, tức và độ dốc ReLU bằng . Độ dốc của theo là . Độ dốc của theo là . Tích hai độ dốc là . Trên đoạn tuyến tính này, một thay đổi nhỏ của đi vào với hệ số , sau khi đã đi qua . Đó là một tích hai thừa số, chưa phải đạo hàm của một chuỗi dài.
Hình dưới đây trải vòng lặp thành các bước cạnh nhau. Các hộp là cùng một bộ trọng số, vẽ lại cho dễ nhìn, không phải ba mạng khác nhau.
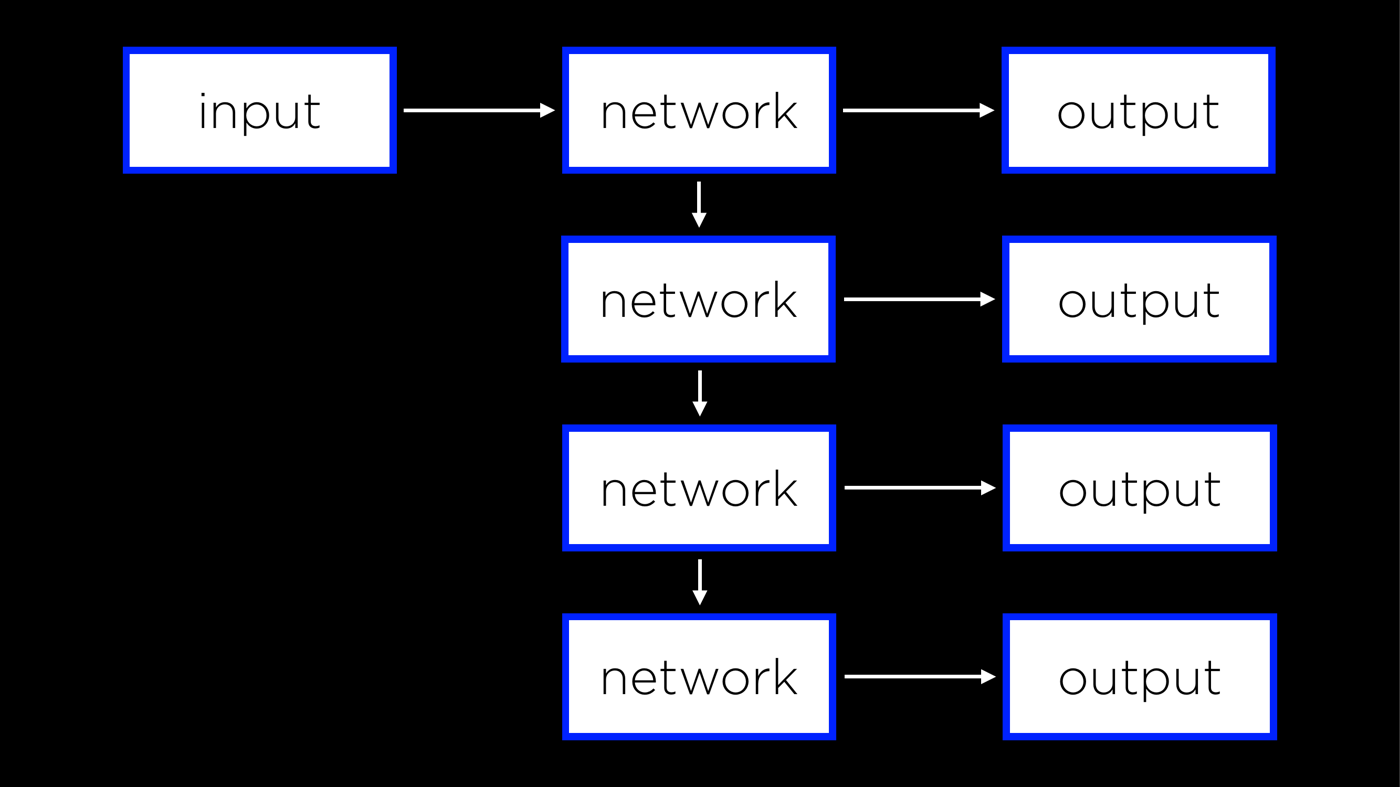
x1 -> [RNN] -> h1
        |
        v
x2 -> [RNN] -> h2
        |
        v
x3 -> [RNN] -> h3
Nếu có một đầu ra tại mỗi bước, đầu ra đó là một hàm của , ví dụ một tầng tuyến tính rồi một softmax khi ta cần phân phối trên các từ. Bài này không tính đầu ra đó, vì câu hỏi đang là trạng thái được cập nhật ra sao. Many-to-one nghĩa là cả chuỗi đi vào và một nhãn đi ra, thường đọc từ trạng thái cuối: một câu thành một nhãn cảm xúc. One-to-many nghĩa là một đầu vào tạo một chuỗi đầu ra. Many-to-many nghĩa là một chuỗi sang một chuỗi, như mỗi khung hình một nhãn, hoặc một câu sang một câu. Cùng một bước trạng thái phục vụ cả ba kiểu; chỗ khác nhau là ta gắn loss vào những bước nào.
3. Cùng một bộ số, vì bước nào cũng là một bước
Chia sẻ theo thời gian giống chia sẻ theo vị trí của một kernel trên ảnh, nhưng trục là thứ tự chứ không phải lưới pixel. Hệ quả thứ nhất: số tham số không tăng theo độ dài chuỗi. Bộ của ví dụ vẫn là ba số dù chuỗi dài mười hay một trăm, trong mô hình một trạng thái vô hướng này. Hệ quả thứ hai: cùng một kiểu chuyển trạng thái được dùng ở mọi bước, nên mạng có cơ hội học “làm gì với đầu vào tiếp theo” mà không học lại từ đầu tại vị trí thứ bốn mươi. Hệ quả thứ ba nằm ở chiều ngược: vì cùng một trọng số xuất hiện nhiều lần trong chuỗi đã trải ra, đạo hàm của loss theo trọng số đó là tổng đóng góp từ các bước. Bài này không viết tổng đó. Chỉ cần thấy một hệ số sẽ bị nhân lặp lại khi tín hiệu đi ngược, và mục thất bại tính các tích đó.
Huấn luyện vẫn là forward, loss, đạo hàm, cập nhật. Forward bây giờ là vòng lặp các bước như mục 2. Loss có thể đặt ở bước cuối, hoặc là tổng loss từng bước nếu mỗi bước có nhãn. Cập nhật sửa , và , tức các số dùng chung, không sửa một bản sao riêng cho .
Một chuỗi ngắn trong ví dụ từ vựng giúp thấy trạng thái là ngữ cảnh. Các xác suất dưới đây là số giả định để đọc, không phải đầu ra của mạng vừa tính:
Hôm -> h1
nay + h1 -> h2
trời + h2 -> h3
Từ , một tầng ra có thể cho điểm các từ tiếp theo. Điều cần giữ là điểm của từ đứng sau “trời” được tính từ , mà đã trộn tại “trời” với , và đã trộn các từ trước. Cắt trạng thái, chỉ nhìn từ “trời”, là một mô hình khác.
Khi cách này thất bại
Lấy tiếp các trọng số của mục 2 và thêm một đầu vào thứ ba bằng , tức , với . Tích đầu vào: . Tích trạng thái: . Cộng bias: . Vậy . ReLU của một số âm là , nên .
Trạng thái bằng , dù từng là và đã làm . Trên các số này, một bước với đầu vào đã kéo tổng về âm và ReLU xóa trạng thái. Phép tính cho thấy giá trị không còn hiện trong . Nó không cho thấy mọi RNN quên sau đúng ba bước; bộ và bias khác sẽ ra khác. Với đúng bộ này, bước thứ ba đã tắt.
Ngay khi ReLU không tắt, hệ số vẫn nhân vào mỗi bước lùi. Tám lần nhân là , tức . Hai mươi lần nhân là . Nếu một loss ở cuối chuỗi gửi tín hiệu ngược và mỗi bước đang ở đoạn độ dốc , tín hiệu tới bước đầu sau hai mươi bước nhỏ hơn một phần triệu nếu tín hiệu xuất phát bằng . Trọng số gần như không được sửa bởi phụ thuộc giữa hai đầu xa nhau. Đây là gradient biến mất theo thời gian, nói bằng một tích, không bằng khai triển đạo hàm của cả đồ thị tính toán. Hệ số trùng của ví dụ chỉ khi độ dốc ReLU bằng . Tại bước của chính ví dụ, độ dốc ReLU bằng vì , nên tín hiệu ngược qua bước đó còn bị chặn hẳn, mạnh hơn việc nhân .
Chiều bùng dùng cùng logic với một hệ số lớn hơn . Nếu mỗi bước nhân , mười bước ra . Cập nhật trừ tốc độ học nhân một số cỡ đó sẽ nhảy rất xa, hoặc thành giá trị không dùng được trong số thực máy tính. Người ta gọi đó là gradient bùng. Dấu hiệu lúc chạy là loss thành một giá trị không hữu hạn sau một vài bước trải chuỗi dài. Cách làm thực hành thường gặp là cắt ngưỡng độ lớn gradient trước khi cập nhật. Bài này không tính một ngưỡng cắt.
Thất bại về mặt bài toán, khác thất bại về mặt tích, là khi dữ liệu không có thứ tự đáng giữ. Một bảng các cột đã tính sẵn, mỗi hàng một sinh viên, không cần trạng thái trừ khi bạn tự ý xếp các cột thành một chuỗi giả. RNN khi đó phải học lại rằng thứ tự do bạn bịa không quan trọng, và tốn một vòng lặp không tương ứng cấu trúc hàng. Dấu hiệu chọn sai là hoán vị các cột, tức đổi thứ tự không có thật, làm dự đoán đổi mạnh. Với chuỗi thật, hoán vị các bước phải đổi ý nghĩa, như hai câu mở bài.
Chuỗi rất dài còn một giới hạn dung lượng: trạng thái một số, như ví dụ, chỉ giữ được những gì các phép nhân-cộng chưa xóa. là một lần xóa thấy được. Trạng thái vector dài hơn chỉ trì hoãn cùng kiểu vấn đề nếu các hệ số lặp lại vẫn nhỏ hơn về thang độ dốc. Đó là lý do các kiến trúc sau thêm một đường nhớ có cổng, thay vì chỉ một bị nhân mỗi bước.
4. LSTM và GRU: cổng nào giữ, cổng nào quên
LSTM, từ long short-term memory, thêm một đường giá trị gọi là cell state, song song với trạng thái ẩn đưa ra ngoài. Các cổng là các hệ số từ đến , thường là đầu ra sigmoid, nhân vào đường đó. Bài này không viết phương trình từng cổng. Khóa kiến trúc học sâu có bài riêng cho công thức và cho việc đọc gradient qua cell: LSTM: cell state và các cổng.
Ở mức quyết định, forget gate, cổng quên, nhân với cell state cũ. Hệ số gần nghĩa là quên phần nhớ đó. Hệ số gần nghĩa là giữ. Input gate, cổng vào, quyết định phần nào của một ứng viên mới được cộng vào cell. Output gate, cổng ra, quyết định phần nào của cell được đưa ra thành trạng thái ẩn ở bước này. Nhờ cell có thể đi qua một cổng gần trong nhiều bước, tín hiệu không bắt buộc phải nhân với một nhỏ tại mỗi bước. Đó là ý “nhớ dài hơn” ở mức cơ chế, không phải một đo đạc rằng mọi LSTM đều nhớ được một câu dài tùy ý.
GRU, từ gated recurrent unit, gọn hơn: nó không tách một cell state riêng khỏi trạng thái ẩn. Update gate trộn trạng thái cũ và một ứng viên mới: nghiêng về trạng thái cũ là giữ, nghiêng về ứng viên là viết đè. Reset gate quyết định trạng thái cũ được đưa vào việc tính ứng viên nhiều hay ít; reset gần nghĩa là ứng viên ít nhìn quá khứ. Công thức và chỗ so với LSTM nằm ở GRU: cổng reset và update. Vài đoạn này đủ để đọc tên cổng. Chúng không đủ để cài đặt hay để chỉnh một LSTM đang phân kỳ.
Trên các bài ngôn ngữ rất lớn, nhiều hệ thống hiện nay dùng attention trong kiến trúc Transformer thay cho vòng lặp từng bước. Bài này không mô tả attention, không mô tả truy vấn và khóa, và không suy ra Transformer từ RNN. Chỗ đó thuộc bài Language của khóa nhập môn và các bài tương ứng trong khóa kiến trúc học sâu. RNN, LSTM và GRU vẫn là công cụ đúng khi chuỗi được đọc từng bước vì dữ liệu đến dần, khi bộ nhớ máy nhỏ, hoặc khi chuỗi ngắn và một trạng thái là đủ. Bảng ở mục đào sâu chỉ là bản đồ chọn, không phải thứ tự thời gian của “cái nào thắng”.
Đào sâu: bản đồ MLP, CNN, RNN trên cùng một câu hỏi dữ liệu
Ba họ mạng trong phần nhập môn này khác nhau ở chỗ lân cận được định nghĩa thế nào. MLP, mạng nối đầy đủ nhiều tầng, coi đầu vào là một vector: không có láng giềng sẵn. CNN coi láng giềng là các ô kề trên lưới, và dùng chung kernel. RNN coi láng giềng là bước thời gian trước, và dùng chung bước nhảy trạng thái. Chọn sai họ là chọn sai láng giềng, rồi mới là chuyện số tầng.
| Kiến trúc | Láng giềng mà công thức nhìn | Dữ liệu hợp dạng này | Một ví dụ giả định |
|---|---|---|---|
| MLP | các tọa độ của một vector | bảng vài cột đã có nghĩa | điểm giữa kỳ và số bài nộp |
| CNN | các ô kề trên lưới | ảnh, bản đồ | ảnh trang bài làm |
| RNN | bước ngay trước, qua | chuỗi | điểm danh theo tuần, câu chữ |
Điểm chung là cả ba đều có tham số, đều có lượt đi tới, đều có loss, và đều có thể được sửa bằng đạo hàm nếu các hàm trên đường đi còn độ dốc. Điểm riêng là công thức buộc đứng sau trong tính toán. Hoán vị thời gian mà không hoán vị cách cập nhật sẽ ra trạng thái khác, như mục 2 sẽ ra số khác nếu đổi với .
Hãy đảo nhanh hai đầu vào của ví dụ để thấy thứ tự không phải trang trí. Giữ , , , , nhưng đưa trước và sau. Bước một: , ReLU cho . Bước hai: , ReLU cho . Trạng thái sau hai bước là , trong khi thứ tự cũ cho . Cùng đa tập hai số, hai thứ tự, hai trạng thái. Phép tính cho thấy bước RNN này không hoán vị được. Một hàm chỉ phụ thuộc tổng sẽ không tách hai thứ tự; tổng ở cả hai cách xếp.
Các bài dùng chuỗi gần một lớp học, toàn tình huống giả định, gồm gợi ý từ khi gõ một câu tiếng Việt, gắn nhãn một câu nhận xét, dự đoán bước tiếp của một cảm biến, và đọc một đoạn video như một dãy khung. Trong mỗi bài, câu hỏi kiểm tra là: nếu xáo trộn thứ tự mà nhãn vẫn nên giữ nguyên, RNN đang bị ép học một thứ tự không có trong đầu bài. Nếu xáo trộn làm nhãn đổi nghĩa, trạng thái theo bước là đúng họ mô hình để thử, sau một baseline không có thứ tự để biết phần thứ tự có đang giúp hay không.
Tự kiểm tra
- Với , , , , , bằng bao nhiêu và bằng bao nhiêu?
- bằng bao nhiêu sau ?
- Với , vì sao ?
- Tích độ dốc từ tới trên đoạn ReLU đang mở bằng bao nhiêu?
- Tám lần nhân còn lại bao nhiêu?
- Cổng nào của LSTM nhân vào cell state cũ để quyết định quên, và cổng nào của GRU trộn trạng thái cũ với ứng viên mới?
- Đảo và trong ví dụ thì trạng thái sau hai bước bằng bao nhiêu, so với ?
Mang đi
RNN chạy lại cùng trọng số tại mỗi bước, và đưa trạng thái trước vào bước sau. Với , , , , , , ta được , , rồi , . Thêm thì và : đầu vào không còn nằm trong trạng thái. Trên đoạn các ReLU đang mở, hệ số từ tới là . Nhân đủ tám lần còn ; đủ hai mươi lần còn . LSTM dùng cổng quên để giữ hay xóa cell state, cổng vào để viết nhớ mới, cổng ra để lộ một phần cell; GRU dùng cổng cập nhật để trộn cũ với mới và cổng reset để ứng viên có nhìn quá khứ hay không. Công thức đầy đủ của các cổng nằm ở khóa kiến trúc học sâu, không nằm trong vài đoạn trên. Đảo thứ tự hai đầu vào của chính ví dụ đổi trạng thái cuối từ thành .
Bài sau đi từ một câu hỏi giả định về ảnh bài làm viết tay đến kiến trúc được chọn, và kết bằng các dấu hiệu cho thấy lựa chọn đó đang sai.
Nguồn tham khảo
- CS50 AI, Lecture 5 - Neural Networks: https://cs50.harvard.edu/ai/notes/5/
- Hochreiter, S., Schmidhuber, J. (1997), Long Short-Term Memory, Neural Computation, DOI: 10.1162/neco.1997.9.8.1735.
- Vaswani, A. et al. (2017), Attention Is All You Need, arXiv:1706.03762.