Convolutional Neural Networks - CNN nhìn ảnh như thế nào?
Bài này trả lời vì sao không nên trải một ảnh thành một vector dài rồi nối mọi pixel vào một tầng dày, và thay vào đó một kernel nhỏ được trượt trên ảnh. Mạng làm vậy gọi là mạng neural tích chập, viết tắt CNN, từ convolutional neural network. Kernel, còn gọi là bộ lọc, là một ma trận trọng số nhỏ. Tích chập ở đây là đặt kernel lên từng mảng ảnh, nhân từng ô tương ứng, rồi cộng lại.
Bạn không cần thuộc bài neuron trước. Một trọng số là một số nhân với một đầu vào. Một tầng nối đầy đủ cho mỗi cặp đầu vào và đơn vị một trọng số riêng. Chia sẻ trọng số nghĩa là cùng một nhóm số của kernel được dùng lại ở mọi vị trí trên ảnh. Bài này tính trọn kernel bên dưới, từng tích và tổng, rồi nói pooling giữ gì và bỏ gì. Bài không thiết kế một kernel lớn hơn, không huấn luyện một mô hình ảnh thật, và không đi vào các họ kiến trúc thị giác sau này.
Các số pixel trong bài là số giả định để cộng tay. Tổng bằng trên mảng đồng nhất và bằng trên mảng có tâm sáng hơn là kết quả của đúng các tích đó, không phải độ chính xác của một máy chẩn đoán.
Đường đọc nhanh: mục 1, mục 2, mục 3, mục 4, mục Khi cách này thất bại, mục 5, rồi phần Mang đi. Các mục Đào sâu nằm ngoài đường đó.
1. Ảnh là một lưới, và tầng dày bỏ cấu trúc lưới
Một ảnh màu có chiều cao, chiều rộng, và các kênh màu. Với ảnh và ba kênh đỏ, xanh lục, xanh dương, số giá trị đầu vào là . Trước hết , rồi . Nếu mỗi giá trị là một đầu vào độc lập của tầng nối đầy đủ, tầng đó không còn biết hai số nào từng đứng cạnh nhau trên ảnh.
Ba hệ quả đi cùng cách trải phẳng đó. Số mũi tên tăng theo số pixel nhân số đơn vị. Hai pixel ở hai góc đối diện được đối xử như hai đặc trưng bảng, dù trên ảnh chúng chẳng kề. Và cùng một nét sáng, nếu dịch sang phải vài pixel, rơi vào các đầu vào khác, nên cần các trọng số khác để nhận ra. CNN đưa vào kiến trúc hai giả định: tín hiệu hữu ích thường là mẫu cục bộ, và cùng một mẫu cục bộ đáng được dò ở nhiều chỗ. Giả định này hợp ảnh, bản đồ, và một số tín hiệu trên lưới. Nó không phải một định lý cho mọi bảng số.
Nối đầy đủ vẫn là một hàm hợp lệ. Với một vector vài chục đặc trưng đã được người ta tính sẵn, tầng dày là một lựa chọn gọn. Phần việc của CNN bắt đầu khi chính sự kề nhau của các ô là thông tin, và khi ta muốn một bộ trọng số nhỏ học mẫu đó thay vì một trọng số cho từng ô.
2. Ví dụ tính tay: chín tích của kernel
Kernel trong mục này là ma trận cố định, kiểu một bộ dò biên đơn giản, chưa phải kết quả huấn luyện. Hàng một là . Hàng hai là . Hàng ba là . Tám ô xung quanh mang , ô giữa mang . Kết luận của phép đặt kernel lên một mảng là một số: tổng chín tích của ô kernel với ô mảng cùng vị trí.
Mảng đầu tiên toàn giá trị , một vùng phẳng:
Từng tích, theo thứ tự hàng từ trên xuống, trái sang phải:
Ô trên-trái: . Ô trên-giữa: . Ô trên-phải: . Ô giữa-trái: . Ô tâm: . Ô giữa-phải: . Ô dưới-trái: . Ô dưới-giữa: . Ô dưới-phải: .
Có tám tích và một tích . Tám lần là . Cộng tâm: . Tổng trên mảng toàn là . Phép tính cho thấy kernel này tắt trên vùng không đổi độ sáng. Nó không cho thấy mọi vùng phẳng của mọi ảnh thật sẽ ra đúng sau một mạng đã học, vì kernel học được có thể khác chín số này.
Mảng thứ hai giữ cùng kernel, chỉ đổi ảnh: tám ô rìa bằng , ô tâm bằng . Đây vẫn là một mảng , không phải một kernel mới.
Từng tích: ở cả tám ô rìa, và ở tâm. Tám lần là . Cộng tâm: . Tổng là , khác .
So hai mảng: mảng phẳng ra , mảng có tâm lệch khỏi rìa ra . Hiệu hai tổng là . Phép tính cho thấy cùng chín trọng số, đáp ứng lớn hơn khi ô giữa khác các ô xung quanh theo hướng mà trọng số tâm đang dương và trọng số rìa đang âm. Nếu tâm tối hơn rìa, các tích đổi dấu và tổng có thể âm; bài này không cần một mảng thứ ba để thấy dấu của tổng phụ thuộc dấu của độ lệch.
Trong CNN, chín số trong thường là tham số. Backpropagation, tức cách tính đạo hàm của loss theo từng tham số, sửa chúng cùng các tầng sau. Ta không bắt buộc phải tự điền và . Kernel viết tay ở trên chỉ để thấy phép nhân-cộng. Một tầng có kernel thì có tổng kiểu này tại mỗi vị trí, tức kênh đặc trưng. Mỗi kernel có thể bật mạnh trên một kiểu mẫu khác nhau: biên đứng, biên ngang, một góc, một vệt màu. Không nên đọc mỗi kênh như một tên gọi đã biết trước khi nhìn trọng số và ảnh.
Khi kernel trượt khắp ảnh, mỗi vị trí cho một số, và các số đó xếp thành một ma trận mới gọi là feature map, bản đồ đặc trưng. Với stride bằng , kernel nhích một pixel mỗi lần. Với padding bằng , tức không thêm viền, một ảnh rộng và kernel rộng cho chiều rộng đầu ra . Cùng công thức cho chiều cao. Đếm vị trí là ô trên một feature map. Mỗi ô là một lần chín tích, với cùng chín trọng số nếu có chia sẻ trọng số.
3. Chia sẻ trọng số: cùng chín số ở mọi vị trí
Giả sử kernel đang phản ứng với một biên đứng. Ta muốn phản ứng đó xảy ra ở góc trái, ở giữa, và ở góc phải, miễn là mẫu cục bộ giống nhau. Cách làm là dùng lại đúng ma trận tại mọi vị trí. Đó là chia sẻ trọng số. Các vị trí không học chín số riêng.
Hãy đếm, trên một kênh, với feature map vừa tính và kernel . Nếu mỗi vị trí có chín trọng số của riêng nó, số trọng số là . Tính , rồi trừ một lần vì nhân là nhân rồi trừ một lần: . Chia sẻ trọng số giảm chín số đó xuống còn cho một kernel trên một kênh vào. Cộng thêm bias cho kernel, nếu có, là thêm một số dùng chung cho cả feature map, không phải một bias mỗi pixel.
Tỉ số . Đúng bằng số vị trí: mỗi vị trí được miễn một bản sao của kernel. Phép đếm cho thấy, trong cách bố trí này, nối cục bộ mà không chia sẻ vẫn tốn trọng số cho một bộ lọc, còn chia sẻ còn . Nó không cho thấy chất lượng phân loại sẽ gấp lần. Nó cho thấy bộ nhớ tham số không còn tỉ lệ với số vị trí.
Người chưa gặp neuron vẫn đọc được câu này: trọng số là số nhân với đầu vào; ở đây đầu vào của một lần đặt kernel là chín giá trị pixel, hoặc chín giá trị trên các kênh tương ứng; cùng một bộ nhân được kéo đi khắp ảnh. Tầng sau có thể là một kernel khác trên các feature map, hoặc một tầng dày sau khi bản đồ đã nhỏ. Huấn luyện vẫn là loss, đạo hàm, và cập nhật, áp vào chín số kia chứ không áp vào một trọng số cho từng pixel.
Chia sẻ trọng số đi cùng một giả định mạnh: mẫu cục bộ có cùng nghĩa ở các vị trí. Một dấu đậm ở ô kiểm góc phiếu và một dấu đậm ở giữa dòng chữ có thể cùng làm kernel bật. Tầng sau còn thấy vị trí trên feature map, nên vẫn có thể học “bật ở góc thì khác bật ở giữa”, miễn là ta chưa xóa tọa độ. Mục pooling và mục thất bại nói chỗ tọa độ bị xóa.
4. Pooling giữ đỉnh và bỏ phần còn lại của cửa sổ
Pooling giảm kích thước feature map bằng một hàm cố định trên từng cửa sổ, thường không có trọng số để học. Max-pooling lấy giá trị lớn nhất trong cửa sổ. Các giá trị còn lại không đi tiếp. Vì vậy pooling giữ độ mạnh của đáp ứng nổi bật nhất trong cửa sổ, và bỏ các đáp ứng yếu hơn cùng vị trí tương đối của đỉnh bên trong cửa sổ.
Ma trận minh họa , stride , cửa sổ , nên bốn cửa sổ không chồng nhau:
Cửa sổ trên-trái gồm . Số lớn nhất là . Ba số bị bỏ là . Cửa sổ trên-phải gồm . Số lớn nhất là . Ba số bị bỏ là . Cửa sổ dưới-trái gồm . Số lớn nhất là . Ba số bị bỏ là . Cửa sổ dưới-phải gồm . Số lớn nhất là . Ba số bị bỏ là .
Bốn đỉnh xếp lại thành
Từ số còn số. Phép tính cho thấy mỗi cửa sổ giữ đúng một max và loại ba số kia. Nó không cho thấy ba số bị loại là vô ích với mọi câu hỏi. Nếu câu hỏi là “cửa sổ có đều sáng hay chỉ một ô sáng”, max không đủ, và mục thất bại đưa hai cửa sổ cùng max.
Trên ảnh , một lần pooling với stride chia mỗi chiều cho : . Lần thứ hai: . Một chuỗi kích thước hay gặp, khi convolution có padding để giữ chiều trước pooling, là:
Input:   224 x 224 x 3
Conv:    224 x 224 x 32
Pool:    112 x 112 x 32
Conv:    112 x 112 x 64
Pool:     56 x  56 x 64
Chiều thứ ba là số kênh. Convolution đầu ra kênh vì có kernel. Pooling không đổi số kênh: nó thu từng bản đồ. Kiểm tra ba câu trước khi nối một tầng dày: chiều cao, chiều rộng, và số kênh. Nối sai một trong ba thì số tham số hoặc không khớp phép nhân ma trận.
Một pipeline đọc được sau khi đã có các mảnh trên: ảnh, convolution cộng ReLU, pooling, lặp lại, rồi gộp các kênh thành một vector, rồi một tầng ra. ReLU là hàm giữ số dương và đổi số âm thành , đặt sau tổng convolution để mạng không chỉ là một chuỗi các phép tuyến tính. Với nhiều lớp loại trừ nhau, tầng cuối thường là softmax, biến các điểm thành số dương có tổng . Với một câu hỏi đúng hoặc sai, sigmoid ở một đơn vị ra là đủ.
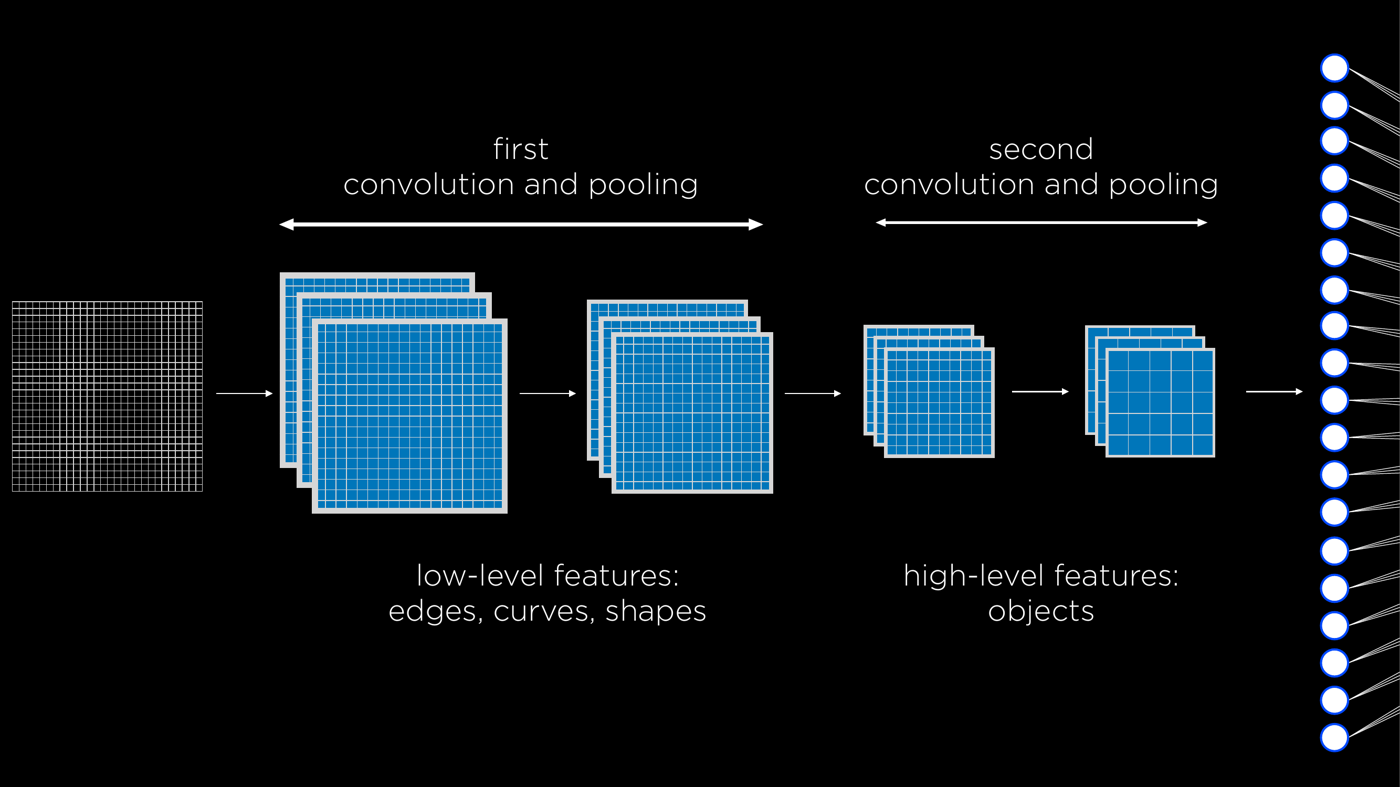
Hình gợi một thứ tự: các tầng đầu phản ứng với mẫu nhỏ, các tầng sau kết hợp chúng. Đó là cách đọc có ích, và là một hình ảnh chứ không phải một cam kết rằng kênh số của một mạng bất kỳ là “bộ dò mép lá”. Biểu diễn thường phân tán trên nhiều kênh. Việc kiểm tra là nhìn feature map hoặc xem lỗi trên từng nhóm ảnh, không phải đặt tên trước cho từng kernel.
Khi cách này thất bại
Max-pooling thất bại khi nhãn phụ thuộc phần đã bị bỏ. Xét hai cửa sổ giả định. Cửa sổ A là . Max là ; ba số bị bỏ là . Cửa sổ B là . Max là ; ba số bị bỏ là . Cả hai cửa sổ ra cùng một số . Phép tính cho thấy bản đồ sau pooling không phân biệt một đỉnh đơn lẻ với một vùng gần như cùng sáng. Nếu câu hỏi là “vùng này có đồng đều sáng không”, đầu ra pooling đã xóa mất bằng chứng trong chính các số bị bỏ.
Một thất bại về vị trí, cùng kiểu. Cửa sổ C là , đỉnh ở ô đầu. Cửa sổ D là , đỉnh ở ô cuối. Max của cả hai là . Phép tính cho thấy max-pooling giữ và bỏ việc đỉnh nằm ở góc nào trong cửa sổ. Một dấu nằm ở ô kiểm phía trên-trái và một dấu nằm ở ô kiểm phía dưới-phải có thể thành cùng một số sau pooling, dù nhãn phiếu khác nhau. Lúc đó pooling, hoặc một lần gộp toàn bản đồ lấy mỗi kênh một số, là bước làm mất câu trả lời.
Chia sẻ trọng số cũng có chỗ không hợp. Nếu cùng một mẫu cục bộ có nghĩa khác nhau ở các vùng và tầng sau không còn tọa độ để phân biệt, kernel dùng chung sẽ kéo các vùng đó về cùng một kiểu đặc trưng. Ảnh có watermark ở giữa, hoặc nền bàn khác nhau giữa các ngày chụp, có thể khiến kernel bật trên vật không phải đối tượng. Dấu hiệu là lỗi tập trung vào một kiểu nền, trong khi vật cần nhận vẫn rõ. Cách đọc là xem các mẫu bị sai, không phải tăng số kênh ngay.
CNN cũng là lựa chọn lệch khi dữ liệu không phải lưới. Một bảng điểm vài cột không có pixel kề để kernel trượt. Một chuỗi sự kiện có thứ tự thời gian cần một trạng thái theo bước, đó là bài mạng hồi tiếp. Một ảnh rất ít, với nhãn vừa đủ đếm, thường cần một mô hình đã học trên ảnh khác rồi chỉ chỉnh các tầng cuối, hơn là học mọi kernel từ đầu trên vài chục tấm. Các câu này là điều kiện dùng, không phải một bảng xếp hạng độ chính xác.
Cuối cùng, kernel của mục 2 nhìn một lân cận rất nhỏ. Một chữ viết chiếm cả trang không nằm gọn trong chín pixel. Tầng sau mới nhìn rộng hơn, và chỉ khi các tầng đó còn giữ được tín hiệu chứ không để pooling xóa mất nét mảnh. Nếu nét cần đọc mỏng hơn cửa sổ pooling, đỉnh có thể biến mất trước khi tầng dày nhìn thấy. Đó là lý do người ta kiểm tra kích thước từng tầng trên một ảnh mẫu, với vật nhỏ nhất mà nhãn còn phụ thuộc vào.
5. Đếm kênh, padding, và stride mà không thêm một kernel mới
Padding thêm một viền, thường bằng , quanh ảnh trước khi trượt. Không có viền, công thức chiều ra của convolution một chiều là , với là độ dài đầu vào, là độ rộng kernel, và là stride, khi phép chia ra số nguyên. Với , , , ta đã được . Muốn giữ với kernel và stride , cần tổng viền hai phía bằng , tức một pixel mỗi bên. Thay vào công thức có padding : . Kết luận của phép này là padding bù đúng phần kernel bị hụt khi stride là , nên chiều ra bằng chiều vào.
Stride là số pixel kernel nhích. Stride tính một đầu ra tại gần như mọi vị trí. Stride nhích hai pixel, nên ít vị trí hơn. Pooling stride ở trên là một dạng nhích như vậy trên cửa sổ max, và nó chia đôi chiều vì cửa sổ và bước cùng bằng trên một chiều chẵn. Không cần thuộc mọi biến thể. Cần biết chiều ra trước khi viết tầng tiếp theo, và tính lại khi đổi stride hoặc padding.
Một tầng convolution với nhiều kênh vào không chỉ có chín trọng số. Nếu feature map phía trước có kênh và kernel không gian vẫn với bộ lọc ra, mỗi bộ lọc có trọng số. Tính , , rồi trọng số, chưa kể bias nếu mỗi bộ lọc một bias. Công thức là tích của chiều kernel, số kênh vào, và số bộ lọc ra. Đây vẫn là chia sẻ theo vị trí: không nhân thêm với . Nếu quên chia sẻ và nhân tiếp với số vị trí, bạn đang đếm một tầng khác, nặng hơn rất nhiều.
So nhanh với một tầng dày trên cùng ảnh đã trải phẳng. Ảnh là đầu vào. Một tầng dày tới đơn vị có trọng số. Tính và , cộng được , chưa kể bias. Kernel một kênh vào và bộ lọc, nếu ảnh đầu chỉ có một kênh, là trọng số. Phép đếm cho thấy hai cách nối không cùng thang tham số. Nó không cho thấy trọng số sẽ thắng trọng số trên mọi ảnh. Nó cho thấy tầng dày đã chi rất nhiều tham số chỉ để nối từng pixel, trước khi học được một mẫu dịch chuyển.
Đào sâu: vùng nhìn rộng dần, và những chỗ CNN không phải lựa chọn đầu
Sau một kernel stride , mỗi số trên feature map phụ thuộc một mảng của ảnh. Đặt thêm một kernel stride lên feature map đó. Đơn vị mới nhìn ba đầu ra kề nhau của tầng trước. Đầu ra bên trái của bộ ba nhìn các pixel đến của một hàng; đầu ra bên phải nhìn các pixel đến . Quãng pixel là . Cùng cách cộng cho chiều dọc: . Vùng ảnh mà một đơn vị tầng hai phụ thuộc, với các giả định stride và không có giãn kernel, là . Đây là đếm độ phủ, không phải một ma trận trọng số thứ hai. Bài này không thêm kernel nào khác ngoài ma trận đã tính tích.
Pooling stride làm bước nhảy trên ảnh gốc lớn hơn, vì một ô sau pooling đại diện cho một cửa sổ. Vùng nhìn vì vậy tăng nhanh hơn so với chỉ xếp kernel stride . Điều đáng nhớ khi gỡ lỗi là một đơn vị ở tầng sâu có thể phụ thuộc một vùng rộng, nên một lỗi ở biên ảnh hoặc một vật bị cắt có thể đổi đầu ra dù kernel từng tầng vẫn nhỏ.
Năm 1998, LeCun, Bottou, Bengio và Haffner mô tả các hệ thống nhận dạng tài liệu dùng mạng tích chập, trên chữ viết và ảnh tài liệu. Năm 2012, AlexNet là một mốc thường được nhắc trên ImageNet, với mạng tích chập sâu, GPU, ReLU và các kỹ thuật regularization. Hai mốc này nói rằng ý tưởng kernel trượt đã có trước làn sóng phần cứng sau này, và rằng dữ liệu cùng máy tính đã đổi mức bài toán giải được. Chúng không nói một CNN mới sẽ đạt cùng một kết quả trên một bộ ảnh lá cây hay bài thi của bạn.
Khi nào để CNN xuống hàng sau. Bảng số nhỏ, với cột đã có nghĩa, thường hợp một mô hình tuyến tính hoặc một mô hình cây, vì không có lưới để chia sẻ trọng số. Chuỗi thời gian và câu chữ có thứ tự; bài sau nói trạng thái theo bước. Ảnh mà camera và nhãn lệch nhau giữa ngày thu thập cần được tách validation theo ngày hoặc theo máy, nếu không kernel sẽ học dấu hiệu của máy ảnh. Và nếu một chỉ số tương phản tính bằng tay trên từng mảng đã tách được các lớp trong kiểm tra sơ bộ, chỉ số đó là baseline. CNN phải hơn baseline đó trên tập giữ lại thì phần kernel mới đang làm việc thêm, chứ không chỉ lặp lại một phép cộng bạn đã viết được.
Tự kiểm tra
- Trên mảng toàn , tám tích và một tích cộng lại bằng bao nhiêu?
- Trên mảng rìa và tâm , tổng chín tích bằng bao nhiêu?
- Cửa sổ giữ số nào, và ba số nào bị bỏ?
- Vì sao cửa sổ và cửa sổ trở nên giống nhau sau max-pooling?
- bằng bao nhiêu, và chia sẻ trọng số còn lại bao nhiêu trọng số cho một kernel một kênh?
- Padding , kernel , stride , ảnh rộng : chiều ra bằng bao nhiêu?
Mang đi
Một ảnh có số. Trải phẳng rồi nối đầy đủ bỏ chuyện pixel nào kề pixel nào và tốn một trọng số mỗi mũi tên. Kernel với tám ô và ô giữa , đặt lên mảng toàn , cho chín tích gồm tám lần và một lần , tổng . Cùng kernel trên rìa và tâm cho tám lần và một lần , tổng . Feature map là bảng các tổng đó khi kernel trượt. Chia sẻ trọng số dùng lại chín số tại mọi vị trí: vị trí trên một bản đồ sẽ cần trọng số nếu mỗi chỗ một kernel, và chỉ cần trọng số khi dùng chung. Max-pooling trên ma trận ví dụ giữ và bỏ ba số còn lại trong mỗi cửa sổ. Hai cửa sổ cùng max cho thấy đỉnh được giữ và cấu trúc còn lại của cửa sổ bị bỏ. Đếm chiều cao, chiều rộng, và số kênh trước khi nối tầng sau.
Bài sau hỏi vì sao cùng một bộ trọng số phải chạy lại dọc theo một chuỗi, và tính hai bước trạng thái ẩn từ các số cho trước.
Nguồn tham khảo
- CS50 AI, Lecture 5 - Neural Networks: https://cs50.harvard.edu/ai/notes/5/
- LeCun, Y., Bottou, L., Bengio, Y., Haffner, P. (1998), Gradient-Based Learning Applied to Document Recognition, Proceedings of the IEEE, DOI: 10.1109/5.726791.
- Krizhevsky, A., Sutskever, I., Hinton, G. E. (2012), ImageNet Classification with Deep Convolutional Neural Networks, NeurIPS.